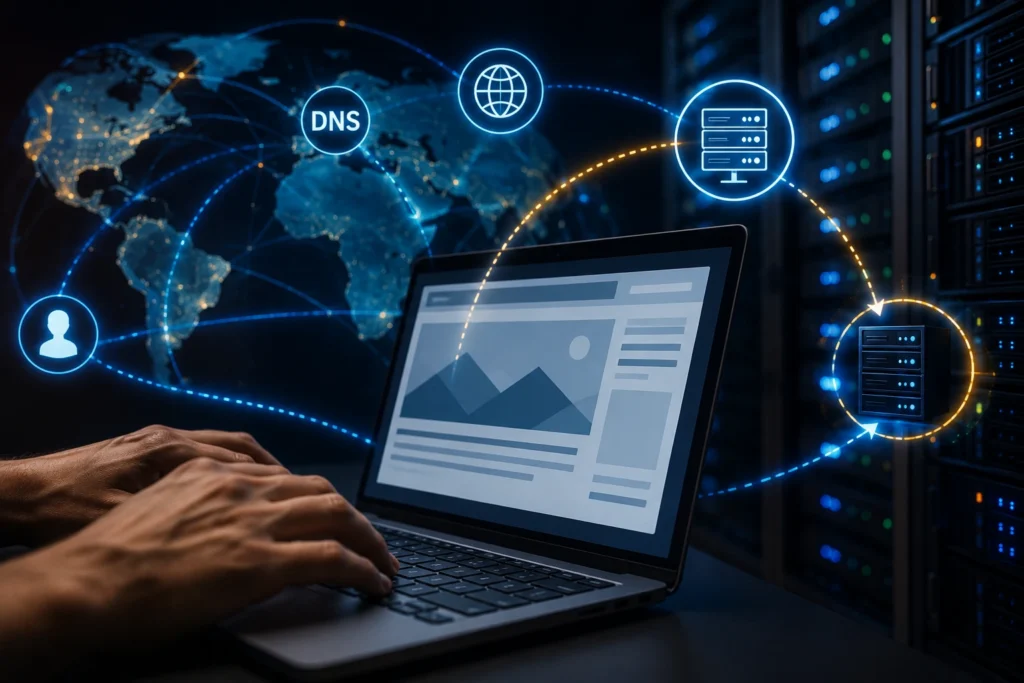
O que acontece depois que você digita um site e pressiona Enter? Embora a página pareça surgir quase instantaneamente, o navegador executa uma sequência coordenada de tarefas. Ele interpreta o endereço, encontra o servidor responsável, estabelece uma comunicação, solicita o conteúdo e transforma arquivos como HTML, CSS, JavaScript e imagens em uma página visível.
Essas etapas podem ocorrer em poucos instantes e, em muitos casos, algumas são realizadas ao mesmo tempo. Ainda assim, cada uma tem uma função específica. Entender esse percurso ajuda a explicar por que determinados sites carregam rapidamente, por que outros exibem o texto antes das imagens e por que uma página pode parecer pronta mesmo quando ainda existem recursos sendo processados.
O que acontece depois que você digita um site
Ao informar um endereço no navegador, o programa interpreta o texto como uma URL, ou localizador uniforme de recursos. Uma URL pode indicar o protocolo de comunicação, o domínio, uma porta específica e o caminho do conteúdo desejado.
Em um endereço hipotético como https://exemplo.com.br/noticias, o trecho https informa que a comunicação deve usar HTTP protegido por TLS. O domínio é exemplo.com.br, enquanto /noticias indica o caminho solicitado dentro do site. Se houver uma porta explicitamente informada, ela também fará parte da interpretação do endereço.
Depois de analisar a URL, o navegador precisa descobrir para qual endereço de rede deve enviar a solicitação. Em seguida, prepara a comunicação, envia o pedido do recurso e aguarda a resposta. Quando o conteúdo chega, começa o trabalho de interpretar os arquivos e montar a interface.
| Etapa | O que acontece | Resultado |
|---|---|---|
| Interpretação da URL | O navegador separa protocolo, domínio, porta e caminho. | O pedido fica definido. |
| Consulta ao DNS | O domínio é associado a um endereço IP disponível. | O navegador identifica um destino de rede. |
| Conexão | O dispositivo prepara a comunicação com o serviço. | O canal fica pronto para transportar dados. |
| Solicitação HTTP | O navegador pede o recurso indicado na URL. | O servidor recebe as instruções do pedido. |
| Resposta e renderização | O conteúdo é recebido, interpretado e desenhado. | A página aparece na tela. |
Essa sequência não é necessariamente uma fila rígida. O navegador pode reaproveitar conexões, utilizar arquivos armazenados em cache e iniciar solicitações paralelas para diferentes recursos. Por isso, a ordem percebida pelo usuário pode variar conforme o site, a rede e o dispositivo.
Como o navegador interpreta o endereço digitado
O navegador começa verificando o formato do texto informado. Se a entrada já parece uma URL completa, ele utiliza as partes presentes para preparar o acesso. Quando a pessoa digita apenas um domínio, o programa pode completar ou testar o protocolo correspondente, de acordo com suas configurações e políticas de segurança.
O domínio é a parte mais importante para localizar o serviço na infraestrutura de nomes da internet. Já o caminho informa qual recurso deve ser pedido depois que o destino for identificado. O DNS não precisa transformar cada parte do caminho em um endereço IP: ele participa principalmente da descoberta do endereço associado ao domínio.
Também podem existir parâmetros depois do caminho, como em /busca?termo=tecnologia. Esses dados são enviados ao servidor na solicitação HTTP e podem influenciar o conteúdo retornado. O navegador, portanto, distingue o destino da conexão do recurso específico que será solicitado nesse destino.
Antes de iniciar todas as etapas, o navegador pode consultar informações que já estejam disponíveis no dispositivo. Ele também pode verificar se uma conexão anterior ainda pode ser reutilizada ou se alguns arquivos da página já estão armazenados localmente. Essas possibilidades reduzem o trabalho necessário em acessos repetidos.
Como o DNS encontra o endereço do site
As pessoas costumam utilizar nomes fáceis de memorizar, como um domínio, enquanto os equipamentos de rede precisam trabalhar com endereços IP. O DNS, sigla em inglês para Sistema de Nomes de Domínio, faz a associação entre essas duas formas de identificação.
Quando uma consulta é necessária, o dispositivo normalmente pergunta a um resolvedor DNS configurado na rede. Esse resolvedor pode ser fornecido pelo provedor de internet, pela organização responsável pela rede ou escolhido pelo próprio usuário. Se já tiver uma resposta válida em cache, ele poderá devolvê-la imediatamente.
Quando não encontra uma informação aproveitável, o resolvedor consulta a hierarquia do DNS para localizar os servidores responsáveis por aquele domínio. O processo pode envolver servidores-raiz, servidores de domínios de primeiro nível e servidores autoritativos. O resultado pode incluir um endereço IPv4, um endereço IPv6 ou informações que indiquem outros serviços necessários para a conexão.
O endereço retornado não representa obrigatoriamente um único computador físico. Um domínio pode utilizar vários endereços para distribuir o tráfego, atender usuários em regiões diferentes, operar por meio de uma rede de distribuição de conteúdo ou manter redundância. O navegador recebe um destino disponível para aquela tentativa, não necessariamente uma descrição completa da infraestrutura do site.
Por que o DNS pode ser reutilizado
As respostas do DNS possuem um período de validade, geralmente definido pelo tempo de vida informado na configuração do domínio. Enquanto esse período não termina, diferentes componentes podem reutilizar a informação: o navegador, o sistema operacional, o roteador e o resolvedor DNS.
Esse armazenamento temporário é chamado de cache. Ele evita que a mesma busca seja refeita sempre que alguém abre uma página do mesmo domínio. Quando o período de validade termina, uma nova consulta pode ser realizada para verificar se o endereço mudou.
Por causa desse mecanismo, uma alteração na infraestrutura de um site pode não ser percebida ao mesmo tempo por todas as pessoas. Alguns resolvedores ainda podem ter a informação anterior, enquanto outros já consultaram os servidores responsáveis e receberam o novo endereço.
Como o dispositivo alcança o servidor
Depois de encontrar um endereço IP, o navegador precisa enviar dados até o serviço correspondente. O computador ou celular geralmente começa pela rede local, que pode incluir uma conexão sem fio, um roteador e outros equipamentos. Em seguida, o tráfego passa pela infraestrutura do provedor e por redes intermediárias até alcançar o destino.
Os dados são organizados em unidades menores, que carregam informações usadas para encaminhamento. Os roteadores observam os endereços de origem e destino e escolhem o próximo ponto do caminho com base nas rotas disponíveis. O percurso não precisa ser sempre igual: ele pode variar conforme a localização, a carga das redes, a disponibilidade dos equipamentos e as decisões de roteamento.
Em uma residência, o roteador também pode realizar a tradução entre endereços internos e o endereço usado para a conexão externa. Isso permite que vários aparelhos compartilhem o acesso à internet. Essa tradução ocorre na infraestrutura da rede e não altera o fato de que o navegador está tentando alcançar o serviço indicado pelo endereço IP obtido.
Durante o transporte, os protocolos de rede ajudam a lidar com divisão, ordenação e transmissão dos dados. Quando a comunicação utiliza TCP, o protocolo oferece mecanismos para confirmar o recebimento e retransmitir informações quando necessário. O objetivo é entregar às camadas superiores um fluxo organizado de dados.
O estabelecimento do TCP
Em uma conexão tradicional baseada em TCP, o dispositivo e o servidor realizam uma breve negociação antes de trocar o conteúdo principal. Essa negociação é conhecida como handshake do TCP. Ela permite que os dois lados estabeleçam parâmetros básicos e confirmem que estão preparados para a comunicação.
O TCP utiliza números de sequência e confirmações para acompanhar os dados. Se a resposta for dividida em vários segmentos, o destinatário consegue reorganizá-los. Quando uma parte não chega corretamente, o protocolo pode solicitar seu reenvio, conforme as condições da conexão.
As portas também têm uma função importante. O endereço IP ajuda a identificar o destino na rede, enquanto a porta indica qual serviço deve receber os dados naquele destino. Em acessos web, as portas mais conhecidas são a 80 para HTTP e a 443 para HTTPS, embora uma aplicação possa utilizar outra porta quando isso estiver configurado.
O TCP acrescenta uma etapa inicial à comunicação, mas conexões persistentes podem ser reaproveitadas para mais de uma solicitação. Dessa forma, depois de carregar o documento principal, o navegador pode utilizar uma conexão existente para solicitar outros arquivos, quando o protocolo e o servidor permitirem.
O que muda quando o site usa HTTPS
O HTTPS protege a comunicação entre o navegador e o serviço web por meio do TLS. Em uma configuração comum sobre TCP, primeiro é estabelecida a conexão de transporte; depois, navegador e servidor negociam os parâmetros da sessão protegida. Só então a solicitação HTTP é transmitida dentro desse canal.
Durante o início da sessão TLS, o servidor apresenta um certificado digital. O navegador verifica se o certificado corresponde ao domínio acessado, se está dentro do período de validade e se a cadeia de confiança é reconhecida pelo sistema. Quando há uma inconsistência, o programa pode mostrar um alerta antes de prosseguir.
O TLS também permite que os dois lados estabeleçam chaves usadas para proteger os dados daquela comunicação. Com isso, o conteúdo trocado fica mais protegido contra leitura e alteração durante o trajeto entre o dispositivo e o servidor.
O HTTPS não substitui o DNS, não elimina a necessidade de uma conexão e não garante que o conteúdo do site seja correto ou confiável em todos os aspectos. Ele protege principalmente a comunicação entre os pontos. O servidor ainda precisa processar a solicitação, e o navegador continua responsável por interpretar o que recebe.
Alguns acessos atuais utilizam QUIC, um protocolo de transporte baseado em UDP que pode transportar HTTP/3. Nesse cenário, o estabelecimento do transporte e a proteção criptográfica seguem um desenho diferente do TCP tradicional, mas o objetivo de proteger a comunicação continua presente.
Como funciona a solicitação HTTP
Depois que o canal adequado está disponível, o navegador envia uma solicitação HTTP. Em uma abertura comum de página, o método costuma ser GET, usado para pedir um recurso sem indicar uma alteração direta no servidor.
O pedido contém o caminho solicitado, como /noticias, além de cabeçalhos que ajudam o servidor a entender o contexto. Entre essas informações podem estar os formatos aceitos, o idioma preferido, dados relacionados ao cache, características do navegador e outras opções relevantes para a resposta.
Cookies associados ao domínio também podem acompanhar a solicitação quando estão disponíveis e quando as regras de segurança permitem. Eles podem guardar preferências ou identificadores de sessão. O navegador controla quando esses dados podem ser enviados, respeitando o domínio, o caminho, a validade e os atributos definidos para cada cookie.
O navegador também pode informar que já possui uma versão anterior do recurso. Com cabeçalhos de validação, o servidor pode verificar se o conteúdo mudou. Se não houve alteração, pode responder que a versão armazenada continua válida, evitando a transferência completa do arquivo.
Como o servidor prepara a resposta
O servidor recebe o pedido e identifica o domínio, o caminho e os demais dados relevantes. O recurso solicitado pode ser um arquivo estático já pronto, como um documento HTML, uma imagem ou uma folha de estilos. Também pode ser uma rota de aplicação que precisa executar operações antes de produzir a resposta.
Em uma página dinâmica, o serviço pode analisar parâmetros, consultar dados internos, aplicar regras e combinar informações com um modelo HTML. O navegador não precisa conhecer todos esses procedimentos. Ele recebe o resultado do processamento, acompanhado de um código de status e de cabeçalhos.
O código de status resume a situação do pedido. Respostas da família 2xx normalmente indicam sucesso; códigos 3xx podem apontar para redirecionamentos; respostas 4xx costumam indicar problemas relacionados ao pedido ou ao recurso solicitado; e respostas 5xx geralmente informam uma falha no processamento do lado do servidor.
Uma resposta HTTP costuma conter três partes principais: o status, os cabeçalhos e o corpo. Os cabeçalhos podem informar o tipo do conteúdo, regras de cache, tamanho, compressão e outras características. O corpo traz os dados solicitados, como o HTML da página.
O servidor pode começar a transmitir o corpo antes de concluir todo o processamento, dependendo da aplicação e da configuração adotada. Quando isso acontece, o navegador pode começar a interpretar o início da resposta enquanto o restante ainda está sendo recebido.
Por que HTML, CSS, JavaScript e imagens chegam separadamente
O HTML recebido inicialmente funciona como uma estrutura e também como um mapa dos recursos adicionais. Ao analisar o documento, o navegador encontra referências a folhas de estilo, scripts, fontes, imagens, vídeos e outros arquivos.
Cada referência pode gerar uma nova solicitação. Uma página, portanto, não costuma chegar como um único arquivo contendo tudo. O HTML pode ser entregue por um servidor, enquanto uma imagem ou uma folha de estilos é fornecida por outro serviço, inclusive por uma rede de distribuição de conteúdo.
O navegador organiza essas solicitações de acordo com prioridades e dependências. Alguns recursos são necessários para construir a apresentação inicial; outros, especialmente os localizados mais abaixo na página, podem ser carregados depois. Arquivos armazenados em cache podem nem precisar ser baixados novamente.
Uma página hipotética pode enviar primeiro um HTML com título, parágrafos e referências a uma folha de estilos e a uma imagem. O navegador lê o documento, solicita os dois recursos e continua preparando a estrutura. O texto pode aparecer antes da imagem porque exige menos processamento e pode estar disponível antes do arquivo visual.
Compressão, tamanho dos arquivos, distância entre as redes, capacidade do servidor e condições da conexão influenciam o tempo de cada resposta. A ordem visual não indica necessariamente a ordem em que todos os recursos foram solicitados.
Como o navegador transforma arquivos em uma página
Receber os dados não basta para exibir um site. O navegador precisa interpretar o HTML, construir sua representação interna, aplicar o CSS, executar scripts quando necessário e desenhar o resultado na janela.
A leitura do HTML e o DOM
O navegador analisa o HTML e identifica elementos como títulos, parágrafos, listas, links, imagens e áreas de navegação. A partir dessa leitura, cria uma estrutura interna conhecida como DOM, sigla em inglês para Modelo de Objetos do Documento.
O DOM representa a relação entre os elementos. Um título pode estar dentro de uma área principal; um link pode estar dentro de um parágrafo; uma imagem pode aparecer depois de uma lista. Essa organização permite que o navegador aplique estilos e que scripts consultem ou modifiquem a estrutura.
A análise pode ocorrer progressivamente conforme o HTML chega. Quando o documento ainda está incompleto, o navegador continua aguardando novos dados para completar a estrutura. Ao encontrar referências a outros recursos, pode iniciar solicitações sem necessariamente esperar o fim de toda a leitura.
O papel do CSS
O CSS define grande parte da aparência visual. Suas regras podem indicar cores, fontes, tamanhos, espaçamentos, bordas, posições e comportamentos adaptados a diferentes dimensões de tela.
Depois de relacionar as regras CSS aos elementos do DOM, o navegador calcula como cada parte deve aparecer. Uma regra pode aumentar o título, organizar uma lista em colunas ou estabelecer a largura máxima do conteúdo. Se uma folha de estilos ainda não chegou, algumas áreas podem aguardar antes de apresentar sua aparência definitiva.
Quando fontes externas são utilizadas, o navegador pode exibir o texto com uma fonte provisória ou aguardar a fonte indicada, conforme as regras do site e do próprio navegador. A troca posterior de fonte pode modificar a largura das palavras e provocar pequenos ajustes no layout.
Layout, pintura e composição
O layout é o cálculo das dimensões e posições dos elementos. Ele leva em conta a janela disponível, o tamanho do texto, as margens, os espaçamentos, as imagens e as relações entre os componentes.
Depois do layout, o navegador realiza a pintura. Nessa fase, prepara textos, cores, fundos, bordas e imagens. Em seguida, combina as diferentes partes para apresentar a composição final na tela. Mudanças posteriores podem exigir novo cálculo ou apenas o redesenho de uma área menor.
Quando uma imagem possui dimensões conhecidas, o navegador pode reservar seu espaço antes de terminar o download. Isso ajuda a evitar que o conteúdo ao redor mude de posição. Se o tamanho não for informado, a chegada da imagem pode provocar um ajuste na organização da página.
O que o JavaScript pode alterar
O JavaScript permite modificar o conteúdo e o comportamento da página depois que o HTML começa a ser analisado. Um script pode preencher uma lista, abrir um menu, atualizar uma área, validar uma interação ou solicitar dados adicionais.
Quando um script insere elementos no DOM, o navegador pode precisar aplicar novamente as regras CSS e recalcular posições. Se a alteração for extensa, mais partes da página poderão ser atualizadas. Se mudar apenas uma propriedade visual, o trabalho pode ficar restrito a uma área menor.
Scripts também podem influenciar o ritmo do carregamento. Um código que precisa ser executado antes de uma etapa importante pode adiar parte da apresentação. Por outro lado, scripts configurados para carregar posteriormente permitem que o conteúdo inicial apareça antes de funções secundárias.
Por que a página aparece antes de terminar de carregar
O navegador não precisa esperar todos os recursos para apresentar os primeiros elementos. Assim que recebe HTML e estilos suficientes, pode desenhar o título, os textos e outras partes disponíveis enquanto imagens, fontes e scripts continuam sendo processados.
Esse carregamento progressivo explica por que o usuário pode ler o começo de um artigo antes que a imagem principal apareça. Também explica por que uma página pode mostrar a estrutura inicial e, depois, ajustar cores, fontes, dimensões ou componentes interativos.
Há uma diferença entre o primeiro conteúdo visível e a conclusão do carregamento. O primeiro indica que alguma parte da página já foi desenhada. A conclusão depende das necessidades do documento, das solicitações pendentes e das tarefas que o navegador ainda precisa executar.
Um site pode parecer pronto para leitura enquanto uma imagem localizada no final continua sendo baixada. Da mesma forma, a área principal pode estar visível enquanto um script prepara uma função que só será usada quando a pessoa interagir com a página.
Por que alguns sites carregam mais rapidamente
A velocidade percebida resulta da combinação de rede, servidor, navegador e estrutura do site. Um domínio já resolvido em cache pode economizar uma etapa. Uma conexão reutilizada pode reduzir novas negociações. Um servidor próximo ou uma rede de distribuição pode diminuir o tempo necessário para receber os arquivos.
O tamanho do HTML, das imagens, das fontes e dos scripts também importa. Arquivos menores tendem a ser transferidos com mais rapidez, embora o tempo final dependa igualmente do processamento realizado pelo navegador.
O modo como o servidor gera o conteúdo influencia o início da resposta. Um arquivo estático pode estar pronto imediatamente, enquanto uma página dinâmica pode precisar consultar dados, montar componentes e aplicar regras antes de enviar o HTML.
A quantidade de recursos também afeta o carregamento. Muitos arquivos pequenos podem gerar diversas solicitações; poucos arquivos muito grandes podem exigir uma transferência prolongada. O navegador administra essas tarefas, mas as dependências entre elas podem fazer com que uma parte precise esperar por outra.
O dispositivo participa da experiência. Depois de receber os dados, ele precisa analisar o HTML, aplicar estilos, executar JavaScript, decodificar imagens e atualizar a tela. Um aparelho com menos capacidade de processamento pode levar mais tempo nessa fase, mesmo conectado à mesma rede de outro dispositivo.
Como identificar onde está a demora
Os navegadores modernos oferecem ferramentas de desenvolvimento que registram as solicitações realizadas durante o carregamento. A área de rede costuma apresentar cada recurso, o momento em que a solicitação começou, o tempo até a resposta e a duração da transferência.
Se o documento HTML demora para começar a chegar, a causa pode estar na descoberta do destino, na conexão, no servidor ou no caminho entre as redes. Se o HTML chega rapidamente, mas uma imagem permanece pendente, o atraso provavelmente está concentrado nesse recurso ou no serviço que o fornece.
Uma linha do tempo também ajuda a diferenciar espera pelo servidor, transferência de dados e processamento local. Essa observação não identifica automaticamente a causa, mas organiza os sinais necessários para uma análise mais precisa.
É importante considerar que um único teste não representa todas as situações. O resultado pode mudar conforme a rede, o dispositivo, a localização, o horário e o estado dos caches. Comparar diferentes acessos ajuda a separar um atraso ocasional de um padrão recorrente.
Perguntas frequentes sobre o carregamento de sites
É necessário consultar o DNS toda vez que uma página é aberta?
Não necessariamente. Se houver uma resposta válida no cache do navegador, do sistema operacional, do roteador ou do resolvedor DNS, ela poderá ser reutilizada. Uma nova consulta pode ser feita quando a informação expira, é removida ou não está disponível.
Mesmo sem uma nova consulta, o navegador ainda precisa estabelecer ou reutilizar uma conexão, enviar a solicitação HTTP e receber os recursos que não estejam armazenados localmente.
Por que o site pode ficar em branco?
A tela pode permanecer em branco quando o navegador ainda não recebeu o documento inicial, quando o servidor demora para responder ou quando um recurso necessário para a apresentação está pendente. Scripts que controlam a montagem da interface também podem atrasar a exibição de determinadas áreas.
Uma tela em branco não aponta para uma única causa. O problema pode estar na rede, no servidor, no navegador ou na própria estrutura do site. Ferramentas de desenvolvimento e mensagens exibidas pelo navegador ajudam a separar essas possibilidades.
Por que o texto costuma aparecer antes das imagens?
O texto pode ser interpretado assim que o HTML e os estilos necessários chegam. A imagem precisa ser solicitada, transferida e decodificada. Além disso, recursos visuais localizados mais abaixo na página podem receber prioridade menor do que o conteúdo inicialmente visível.
Quando as dimensões da imagem são conhecidas, o navegador pode reservar o espaço antes de concluir o download. Isso permite que o texto seja exibido sem grandes mudanças de posição quando a imagem aparecer.
O que ocorre quando um servidor demora a responder?
O navegador aguarda a resposta dentro dos limites definidos para aquela comunicação. Nesse período, pode mostrar uma página parcialmente carregada, um indicador de espera ou apenas a área inicial disponível.
Se o limite for ultrapassado, a conexão pode terminar com uma mensagem de erro. A causa pode ser o processamento do servidor, o caminho entre as redes, uma falha temporária ou a impossibilidade de localizar o recurso solicitado.
A página está pronta quando o primeiro conteúdo aparece?
Não obrigatoriamente. O primeiro conteúdo visível indica que uma parte da página já foi processada, mas imagens, fontes, scripts e outros componentes podem continuar sendo carregados. A conclusão ocorre quando as tarefas relevantes para aquela página são finalizadas ou quando o navegador já não precisa aguardar recursos essenciais.
Da digitação à página visível
O caminho entre digitar um site e visualizar seu conteúdo reúne várias etapas conectadas. O navegador interpreta a URL, consulta ou reutiliza informações do DNS, encontra um destino, prepara a comunicação e envia uma solicitação HTTP.
O servidor analisa esse pedido e devolve uma resposta que pode conter HTML, instruções de cache e referências a outros recursos. O navegador então solicita arquivos complementares, constrói o DOM, aplica o CSS, executa JavaScript quando necessário, calcula o layout, pinta os elementos e compõe a imagem apresentada na tela.
Algumas tarefas acontecem em sequência; outras ocorrem em paralelo. É por isso que o texto pode aparecer antes de uma imagem, que um menu pode ser ajustado depois e que uma página aparentemente pronta ainda pode estar recebendo dados.
O resultado final depende da colaboração entre navegador, dispositivo, rede, servidor e conteúdo do site. Compreender essa sequência torna mais fácil interpretar diferenças de velocidade e localizar em qual etapa um carregamento pode estar demorando.
Na próxima vez que você pressionar Enter, a página visível será apenas a parte mais perceptível de um processo que envolve nomes de domínio, protocolos, servidores, arquivos e cálculos realizados em poucos instantes.